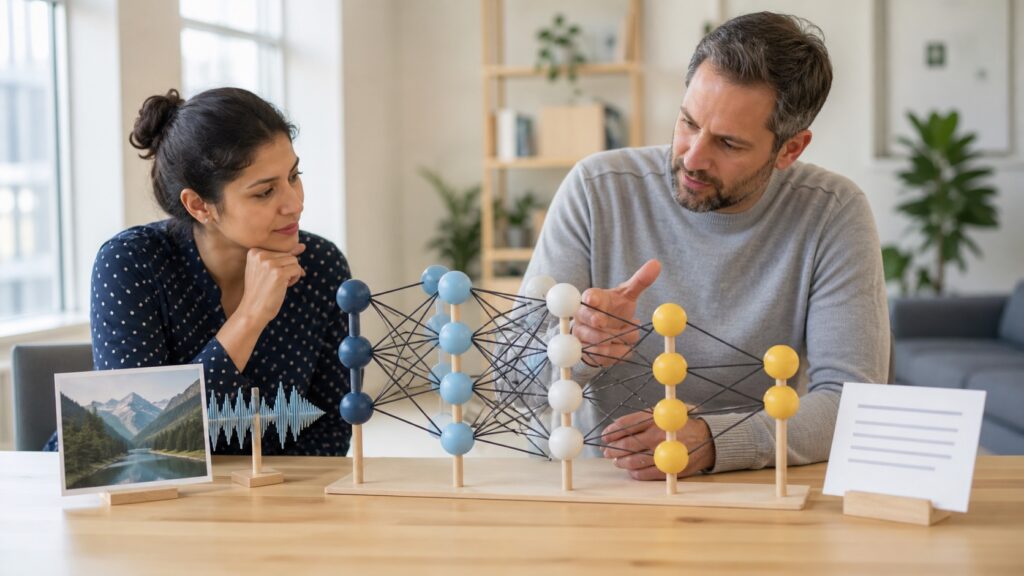
Короткий ответ. Нейронная сеть — это математическая модель машинного обучения, состоящая из связанных вычислительных узлов и настраиваемых параметров. Она получает примеры, вычисляет результат, сравнивает его с правильным ответом и постепенно меняет параметры, чтобы уменьшить ошибку. Нейросеть не копирует человеческий мозг и не «думает» в бытовом смысле, но умеет находить сложные закономерности в тексте, изображениях, звуке и числовых данных.
Искусственный интеллект, машинное обучение и нейросеть: в чём разница
Эти понятия часто используют как синонимы, хотя между ними есть иерархия.
- Искусственный интеллект (ИИ) — широкая область систем, которые выполняют задачи, связанные с восприятием, прогнозированием, рекомендациями, решениями и другими интеллектуальными функциями.
- Машинное обучение (ML, machine learning) — часть ИИ, где правила поведения не полностью задаются вручную: модель настраивается на данных.
- Нейронная сеть — один из классов моделей машинного обучения.
- Глубокое обучение — работа с нейросетями, содержащими много последовательных слоёв преобразований.
Не всякий ИИ является нейросетью. Экспертная система с набором правил, алгоритм поиска пути и обычная статистическая модель тоже могут входить в решения ИИ. И наоборот, нейросеть сама по себе ещё не готовый продукт: нужны данные, интерфейс, инфраструктура, контроль качества и понятный бизнес-процесс.
Из чего состоит нейронная сеть
Упрощённо сеть включает входной слой, один или несколько скрытых слоёв и выход. Каждый искусственный нейрон получает числа, умножает их на веса, складывает результат со смещением и пропускает через нелинейную функцию активации.
Веса показывают, насколько важен конкретный сигнал. Смещение позволяет сдвинуть границу решения. Функция активации делает модель нелинейной: без неё много слоёв свелись бы к одному линейному преобразованию и не смогли бы описывать сложные зависимости.
Представим модель, которая определяет, есть ли на фотографии кошка. На вход поступают числа, соответствующие пикселям. Ранние слои могут реагировать на границы и направления линий, следующие — на текстуры и формы, более глубокие — на сочетания признаков. Это удобное объяснение, но нельзя считать, что каждый нейрон имеет понятную человеку функцию. Представления обычно распределены между множеством параметров.
Как нейросеть обучается
1. Подготовка данных
Модели показывают примеры. Для классификации изображений это могут быть фотографии с метками «кошка» и «не кошка». Для прогнозирования спроса — исторические продажи, цены, сезонность и фактический результат. Для языковой модели — последовательности токенов.
Качество данных критично. Если выборка мала, содержит ошибки или не представляет реальную ситуацию, сеть выучит неправильные закономерности. Большой объём не компенсирует систематический перекос.
2. Прямой проход
Данные проходят через слои, и сеть выдаёт прогноз. В начале веса обычно не настроены, поэтому результат слабый.
3. Функция потерь
Специальная формула измеряет расхождение между прогнозом и правильным ответом. Для разных задач используют разные функции потерь. В классификации важно, насколько верная категория получила высокую вероятность; в числовом прогнозе — насколько велико отклонение.
4. Обратное распространение ошибки
Алгоритм backpropagation вычисляет, как каждый параметр повлиял на ошибку. Оптимизатор меняет веса в направлении, которое должно уменьшить потери. Один такой шаг не решает задачу: процесс повторяется на множестве пакетов данных.
5. Проверка на данных, которых модель не видела
Данные делят как минимум на обучающую и тестовую части. Часто используют ещё валидационную выборку для подбора настроек. Если проверять модель на тех же примерах, по которым она училась, можно принять запоминание за способность работать в реальности.
Что такое эпоха, batch и learning rate
Эпоха — один проход по обучающему набору. Batch, или пакет, — небольшая группа примеров, по которой рассчитывают очередное обновление. Learning rate, скорость обучения, определяет размер изменения параметров.
Слишком большая скорость может заставить оптимизацию перескакивать через хорошее решение, слишком маленькая — сделать обучение медленным. Большее число эпох не всегда лучше: после определённого момента сеть способна начать запоминать детали обучающей выборки и хуже работать на новых данных.
Переобучение и недообучение
Недообучение возникает, когда модель слишком проста, обучалась недостаточно или не получила полезных признаков. Она плохо работает и на обучающих, и на новых данных.
Переобучение — ситуация, когда модель хорошо запомнила обучение, но не обобщает закономерность. Например, классификатор научился узнавать не заболевание, а обозначение конкретного аппарата на снимках из одной клиники.
Для борьбы с переобучением применяют больше разнообразных данных, регуляризацию, аугментации, раннюю остановку и модели подходящей сложности. Главная защита — честная проверка на данных, близких к будущим условиям эксплуатации.
Основные виды нейронных сетей
Полносвязные сети
В простейшем варианте каждый узел слоя соединён со всеми узлами следующего. Такие сети подходят для некоторых табличных задач, но для изображений и длинных последовательностей часто используют специализированные архитектуры.
Свёрточные сети (CNN)
Свёрточные нейросети эффективно ищут локальные признаки и долго были основной архитектурой компьютерного зрения. Они применяются в распознавании объектов, дефектов, медицинских изображений и документов.
Рекуррентные сети (RNN, LSTM, GRU)
Эти модели обрабатывают последовательность по шагам и передают внутреннее состояние дальше. Их использовали для текста, речи и временных рядов. На длинных последовательностях обучение и сохранение дальних зависимостей затруднялись, что стало одной из причин роста популярности Transformer.
Transformer
Transformer использует механизм внимания, позволяющий связывать разные части последовательности и эффективнее распараллеливать обучение, чем рекуррентные схемы, описанные в исходной работе. Эта архитектура стала основой многих больших языковых моделей. Возможности конкретной системы, включая работу с изображениями или звуком, нужно проверять по её актуальной документации.
Генеративные модели
Автоэнкодеры, GAN, диффузионные модели и авторегрессионные Transformer создают новые данные. Они обучаются по разным принципам. В работе Ho, Jain и Abbeel диффузионная вероятностная модель формирует изображение через процесс, связанный с поэтапным удалением шума.
Как нейросеть распознаёт изображение
Фотография превращается в массив чисел. Модель вычисляет признаки и выдаёт вероятности классов: например, «кошка — 0,82», «собака — 0,12». Это не абсолютная уверенность и не гарантия правильности. Вероятности могут быть плохо откалиброваны, особенно на необычных изображениях.
Если модель обучалась на дневных фотографиях, ночная камера может ухудшить результат. Поэтому важны тесты на разных устройствах, освещении, ракурсах и группах пользователей. Даже гипотетическая средняя точность 95% сама по себе не показывает, в каких случаях сосредоточены ошибки и насколько они опасны. Отдельно нужно проверять калибровку вероятностей: исследование Guo и соавторов показало, что высокая уверенность современной нейросети не всегда соответствует фактической доле правильных ответов.
Как нейросеть генерирует текст
В авторегрессионной языковой модели текст делится на токены и превращается в числовые представления. Модель оценивает вероятности следующего токена, выбирает продолжение и повторяет процесс. Способ последующей настройки зависит от конкретной модели и должен подтверждаться её техническим отчётом или карточкой модели.
Модель может создавать связный и полезный текст, потому что усвоила сложные закономерности языка. Но правдоподобие не равно фактической точности. Если нужен свежий или критически важный факт, ответ следует сверять с первичным источником.
Почему нейросеть ошибается
Основные причины:
- данные не соответствуют реальной задаче;
- в выборке есть ошибки и перекосы;
- условия после запуска изменились;
- модель встретила редкий случай;
- метрика не отражает реальную цену ошибки;
- пользователь применяет систему не так, как предполагалось;
- генеративная модель выдаёт вероятное, но неподтверждённое продолжение.
Ошибку нельзя устранить одним хорошим промптом. Нужны данные, тесты, наблюдение после запуска и процедура передачи сложного случая человеку.
Нейросеть и человеческий мозг
Название появилось из исторического вдохновения биологией, но искусственный нейрон — очень грубая математическая абстракция. Современная сеть не является цифровой копией мозга. Она обучается другими способами, требует иных ресурсов и не доказывает наличие сознания.
Сравнение полезно только как метафора: много простых элементов совместно создают сложное поведение. Делать из неё вывод «сеть мыслит как человек» неправильно.
Где нейросети применяются
Нейросети используются для распознавания речи, машинного перевода, поиска объектов на изображениях, генерации текста и изображений, рекомендаций, выявления аномалий, прогнозирования и помощи программистам. Но выбор технологии должен начинаться с задачи, а не с модного слова.
Для небольшой таблицы продаж нейросеть стоит сравнить с более простыми методами — например, статистической моделью или градиентным бустингом. Выбор оправдан только после теста на одной и той же выборке с учётом точности, стоимости, скорости и объяснимости результата.
Как безопасно начать пользоваться нейросетью
- Выберите задачу с низкой ценой ошибки: черновик, конспект или варианты идей.
- Не передавайте пароли, персональные данные и коммерческую тайну, пока не проверены условия конкретного продукта, настройки хранения и правила вашей организации.
- Дайте модели цель, контекст и формат ответа.
- Попросите отделить факты от предположений.
- Проверьте имена, даты, цифры и ссылки.
- Для регулярной работы сохраните тестовые примеры и сравнивайте качество после обновлений.
- Не передавайте модели окончательное решение там, где нужна профессиональная ответственность.
Как оценивать нейросеть для бизнеса
Начните с небольшого, но репрезентативного набора реальных случаев и заранее определите правильный результат. Размер набора зависит от разнообразия задачи и цены ошибки: универсального числа нет. Сравните систему с текущим процессом по точности, времени, стоимости и числу критических ошибок. Отдельно измеряйте случаи, где модель должна отказаться или передать задачу человеку.
Пилот должен ответить не «нейросеть впечатляет?», а «уменьшила ли она время обработки без роста риска?». Если эффект нельзя измерить, масштабировать внедрение рано.
Частые вопросы
Нейросеть — это программа?
Да, но её поведение определяется не только кодом, а также обученными параметрами, данными и настройками. Продукт вокруг сети включает ещё интерфейс и бизнес-логику.
Может ли нейросеть учиться сама во время разговора?
Изменение ответа внутри диалога не доказывает, что параметры модели обновились: система может просто учитывать предыдущие сообщения как контекст. Использование переписки поставщиком, сроки хранения и доступные настройки нужно проверять в действующих условиях именно выбранного продукта.
Бесплатная нейросеть хуже платной?
Цена тарифа сама по себе не показывает качество на вашей задаче. Сравнивайте результат на одинаковых примерах, а текущие лимиты, доступную модель и условия обработки данных сверяйте на официальной странице продукта в день выбора.
Нужен ли мощный компьютер?
При использовании облачного продукта основная вычислительная нагрузка обычно находится на стороне поставщика. Для локального запуска требования зависят от конкретной модели, формата весов и способа оптимизации; их следует брать из официальной карточки модели и документации проекта, а не оценивать по общему названию «нейросеть».
Нейросеть заменит программиста, дизайнера или автора?
По одному удачному примеру нельзя сделать вывод о судьбе профессии. Практический вопрос уже сейчас другой: какие отдельные операции система выполняет на приемлемом уровне и где по-прежнему нужны постановка цели, проверка фактов, контекст и ответственность человека.
Вывод
Нейронная сеть — это обучаемая математическая модель, которая настраивает множество параметров по примерам. Её сила — в поиске сложных закономерностей; слабость — в зависимости от данных, условий и качества проверки. Для пользователя важнее не число слоёв, а то, решает ли модель конкретную задачу, как часто ошибается и кто контролирует последствия.
Первичные источники и документация
- NIST: Artificial Intelligence in the Fire Service, раздел с определениями ML и neural networks — https://nvlpubs.nist.gov/nistpubs/SpecialPublications/NIST.SP.1500-29.pdf
- NIST: определение искусственного интеллекта — https://csrc.nist.gov/glossary/term/artificial_intelligence
- Vaswani et al.: Attention Is All You Need — https://arxiv.org/abs/1706.03762
- Ho, Jain, Abbeel: Denoising Diffusion Probabilistic Models — https://arxiv.org/abs/2006.11239
- Guo et al.: On Calibration of Modern Neural Networks — https://proceedings.mlr.press/v70/guo17a.html
- Google Machine Learning Glossary — https://developers.google.com/machine-learning/glossary/
Материал проверен и актуализирован 30 августа 2026 года. Для выбора конкретного сервиса сверяйте текущие возможности, ограничения и правила обработки данных в официальной документации.
Добавить комментарий